

이미지와 스캔 PDF에서 텍스트 추출
이미지 파일과 스캔 PDF 문서의 텍스트를 인식하여 이미지 안에 포함되어 있던 내용을 복사하고 검색하고 편집할 수 있도록 합니다.
텍스트가 포함된 이미지와 스캔 문서를 편집 가능한 텍스트로 변환하세요. 이미지와 PDF를 여러 개 한 번에 추가하고, OCR이 읽는 영역을 미리 보기에서 확인할 수 있습니다. 인식된 텍스트를 검토하고 수정한 다음 원하는 폴더로 내보내세요. 텍스트 인식은 사용자의 컴퓨터에서 실행됩니다.
기능
이미지 파일과 스캔 PDF 문서의 텍스트를 인식하여 이미지 안에 포함되어 있던 내용을 복사하고 검색하고 편집할 수 있도록 합니다.
문서에 맞는 인식 언어를 선택할 수 있습니다. 중국어, 영어, 일본어 및 라틴 문자 텍스트를 지원합니다.
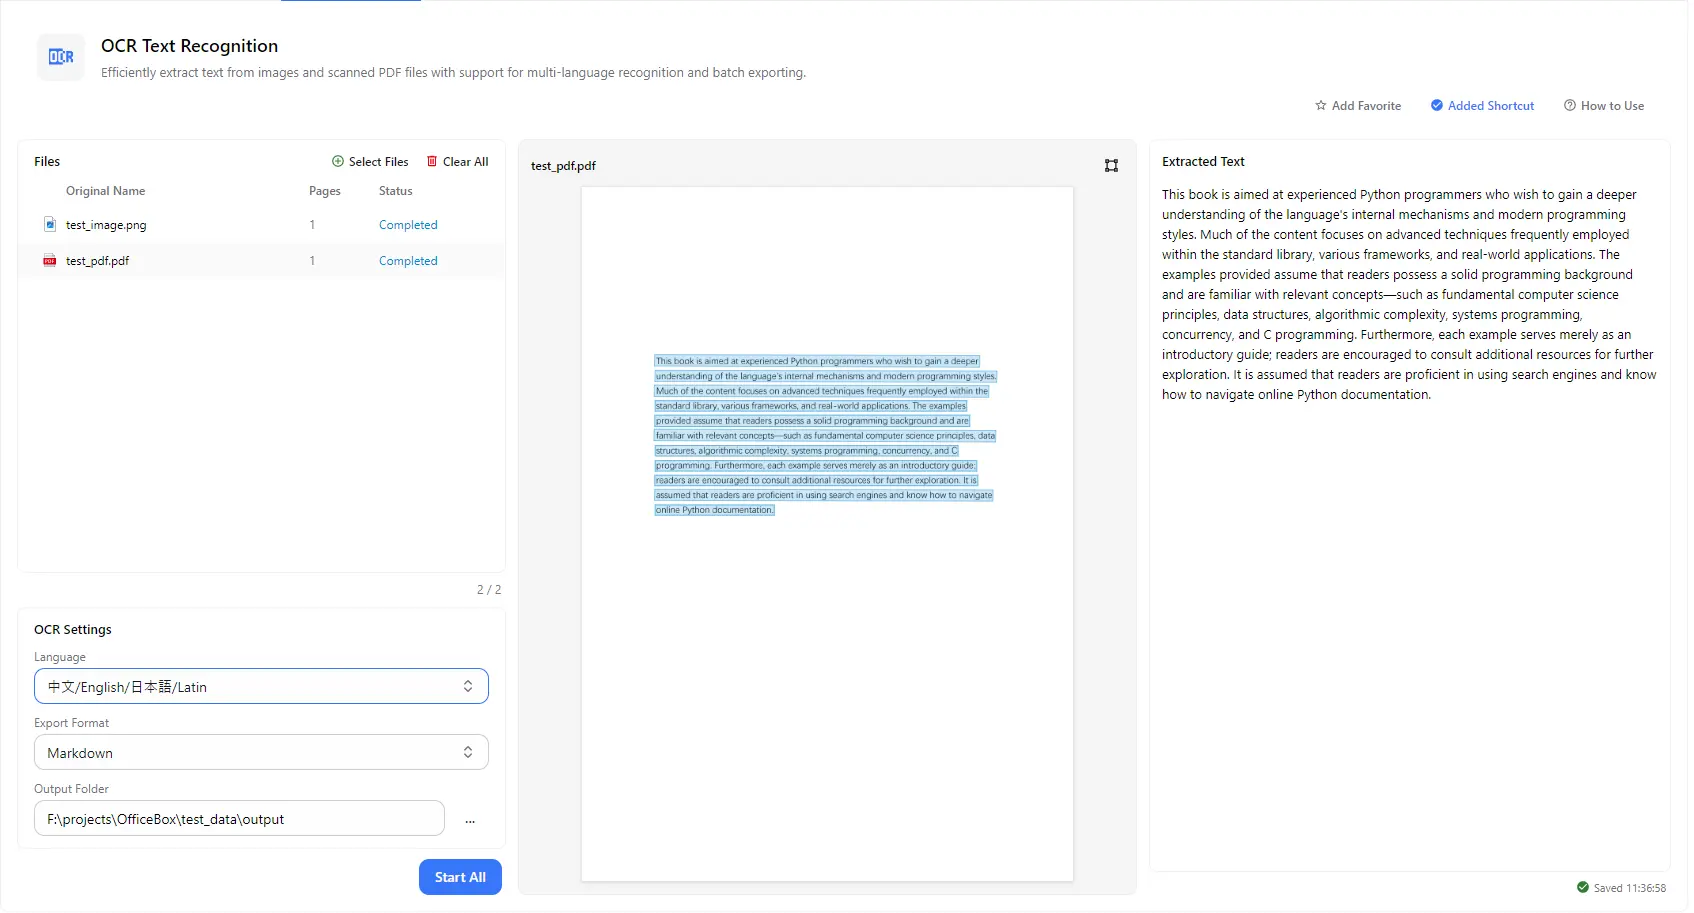
여러 이미지와 PDF를 추가한 다음 '모두 시작'을 한 번만 클릭하여 함께 처리할 수 있습니다. 파일 목록에서 각 파일의 페이지 수와 처리 상태를 확인할 수 있습니다.
감지된 텍스트 영역이 강조 표시된 페이지를 확인하여 OCR이 페이지의 올바른 부분을 읽고 있는지 살펴볼 수 있습니다.
원본 페이지 옆에서 인식된 텍스트를 확인하고 텍스트 패널에서 오류를 바로 수정할 수 있습니다. 수정 내용은 해당 텍스트 파일에 자동으로 저장됩니다.
Markdown과 같은 내보내기 형식과 추출된 텍스트 파일을 저장할 폴더를 선택할 수 있습니다.
이용 방법
PurZeno를 실행하고 도구 목록에서 'OCR 텍스트 인식'을 선택합니다.
'파일 선택'을 클릭하여 이미지나 PDF를 추가합니다. 인식 언어와 내보내기 형식을 선택한 다음 각 파일의 미리 보기와 추출된 텍스트를 확인합니다.
출력 폴더를 선택하고 '모두 시작'을 클릭합니다. 필요한 경우 텍스트 패널에서 오류를 수정한 다음 선택한 폴더에서 텍스트 파일을 확인할 수 있습니다.
활용 사례
스캔 PDF와 촬영한 문서 페이지를 검색하고 복사하여 다른 문서에서 다시 사용할 수 있는 텍스트로 변환합니다.
스크린샷, 슬라이드, 포스터 및 인쇄물 사진에서 텍스트를 추출하여 직접 다시 입력하는 수고를 줄일 수 있습니다.
책, 논문 및 인쇄된 노트의 페이지를 Markdown 또는 텍스트 파일로 변환하여 학습, 인용 및 정리에 활용할 수 있습니다.
중국어, 영어, 일본어 및 라틴 문자 텍스트에 맞춘 언어 설정을 사용하여 여러 언어가 섞인 문서와 다국어 콘텐츠를 인식할 수 있습니다.
알아두면 좋은 점
'파일 선택'을 클릭하여 이미지를 추가하고 인식 언어와 내보내기 형식을 선택합니다. 출력 폴더를 지정한 다음 '모두 시작'을 클릭하세요. 추출된 텍스트는 텍스트 패널에 표시되고 선택한 폴더에 저장됩니다.
스캔 PDF를 추가하고 언어를 선택한 다음 '모두 시작'을 클릭합니다. 모든 페이지의 텍스트가 인식되며 Markdown과 같이 선택한 형식으로 내보내집니다.
인식 언어 목록에는 중국어, 영어, 일본어 및 라틴 문자 텍스트가 포함되어 있습니다. 문서에 맞는 설정을 선택하세요.
네. 추출된 텍스트 패널에서 오류를 바로 수정할 수 있습니다. 수정 내용은 해당 텍스트 파일에 자동으로 저장됩니다.
선명하고 조명이 충분하며 텍스트가 똑바로 배치되고 명암 대비가 좋은 이미지나 스캔 파일을 사용하세요. 문서에 맞는 언어를 선택하고 미리 보기에서 강조 표시된 영역을 확인하여 텍스트가 올바르게 인식되는지 살펴보세요.
OCR을 처음 사용할 때 PurZeno가 해당 기능에 필요한 모델을 다운로드합니다. 일반적으로 다시 다운로드할 필요는 없지만 모델이 업데이트되거나 다시 받아야 하는 경우에는 추가 다운로드가 필요할 수 있습니다. 특정 작업에 맞게 설계된 소형 모델이며, 일반적으로 몇 MB에서 약 100MB 정도입니다.
아니요. 모델을 다운로드한 후에는 사용자의 컴퓨터에서 로컬로 실행됩니다. 파일은 어떤 서버에도 업로드되지 않습니다.
AI 모델은 컴퓨터에서 로컬로 실행되므로 처리 속도는 주로 CPU와 메모리 등 컴퓨터 하드웨어에 따라 달라집니다. 사용하는 장치에 따라 처리 시간이 다를 수 있습니다.